每天 10 分鐘,打造一個沒幻覺的 AI 知識庫
-
00:00
1.
30 分鐘,建立基礎的 AI 知識庫
播放影片: https://service.cwisdom.tw/media/1595
主題索引
做法很簡單!
只要將整理好的文件檔案 (如請假制度、行政流程、SOP 等),直接拖曳到 xms+ AI 知識庫系統,AI 就能依據內部的文件回答企業內專屬的問題囉。
而原本負責回答的專家,
則從「回答」改成每天從統計資料中「檢查」
同事問了什麼問題、AI 怎麼回答
如果 AI 回答的很好,
就存成 FAQ,下次問類似的問題,費用直接節省 10,000 倍!
還能藉此向 AI 學習、獲得成長呢。
萬一回答有問題呢?
那就即時亡羊補牢,提醒當初提問的人,以及修正後存成 FAQ 就好。
如果想要更保守,
也可以只開放給自己用就好,在回答別人的問題之前,都先問 AI,讓 AI 幫你找到答案或提供怎麼回答的內容。
畢竟 AI 的正確率與品質比一般人高太多了,可以成為一個很棒的輔助。
一個小小簡單的動作和改變
- 將文件丟給 AI
- 角色從「回答」改成「檢查」
就能帶來驚人的效益
- 減少大量重複回答的負擔
- 更快、更好的品質
- 收集真實的需求 (會問,代表需求)
- 記錄隱性經驗 (回答,就是經驗)
如何操作呢?
5% 帶來的效益
雖然這些佔資深員工的經驗比例不高 (5%),
但依然很有價值、也非常實用!
因為光是這 5% 的規定,
就佔了人資或行政每天許多重複性的回答,把這些瑣碎的常見問題、SOP 等直接丟給 AI,馬上就能幫團隊省下大把時間,讓我們更能專注在真正重要的事情上。
之後再持續收集新的問題與回答,
讓知識庫不斷成長,就能形成企業的動態知識大腦。
AI,比資深專家更厲害
此外,xms+ AI 更導入進階的 agentic 技術並且優化,
能試著了解使用者想問的問題,找到參考文件並「分析」後回答。
例如:
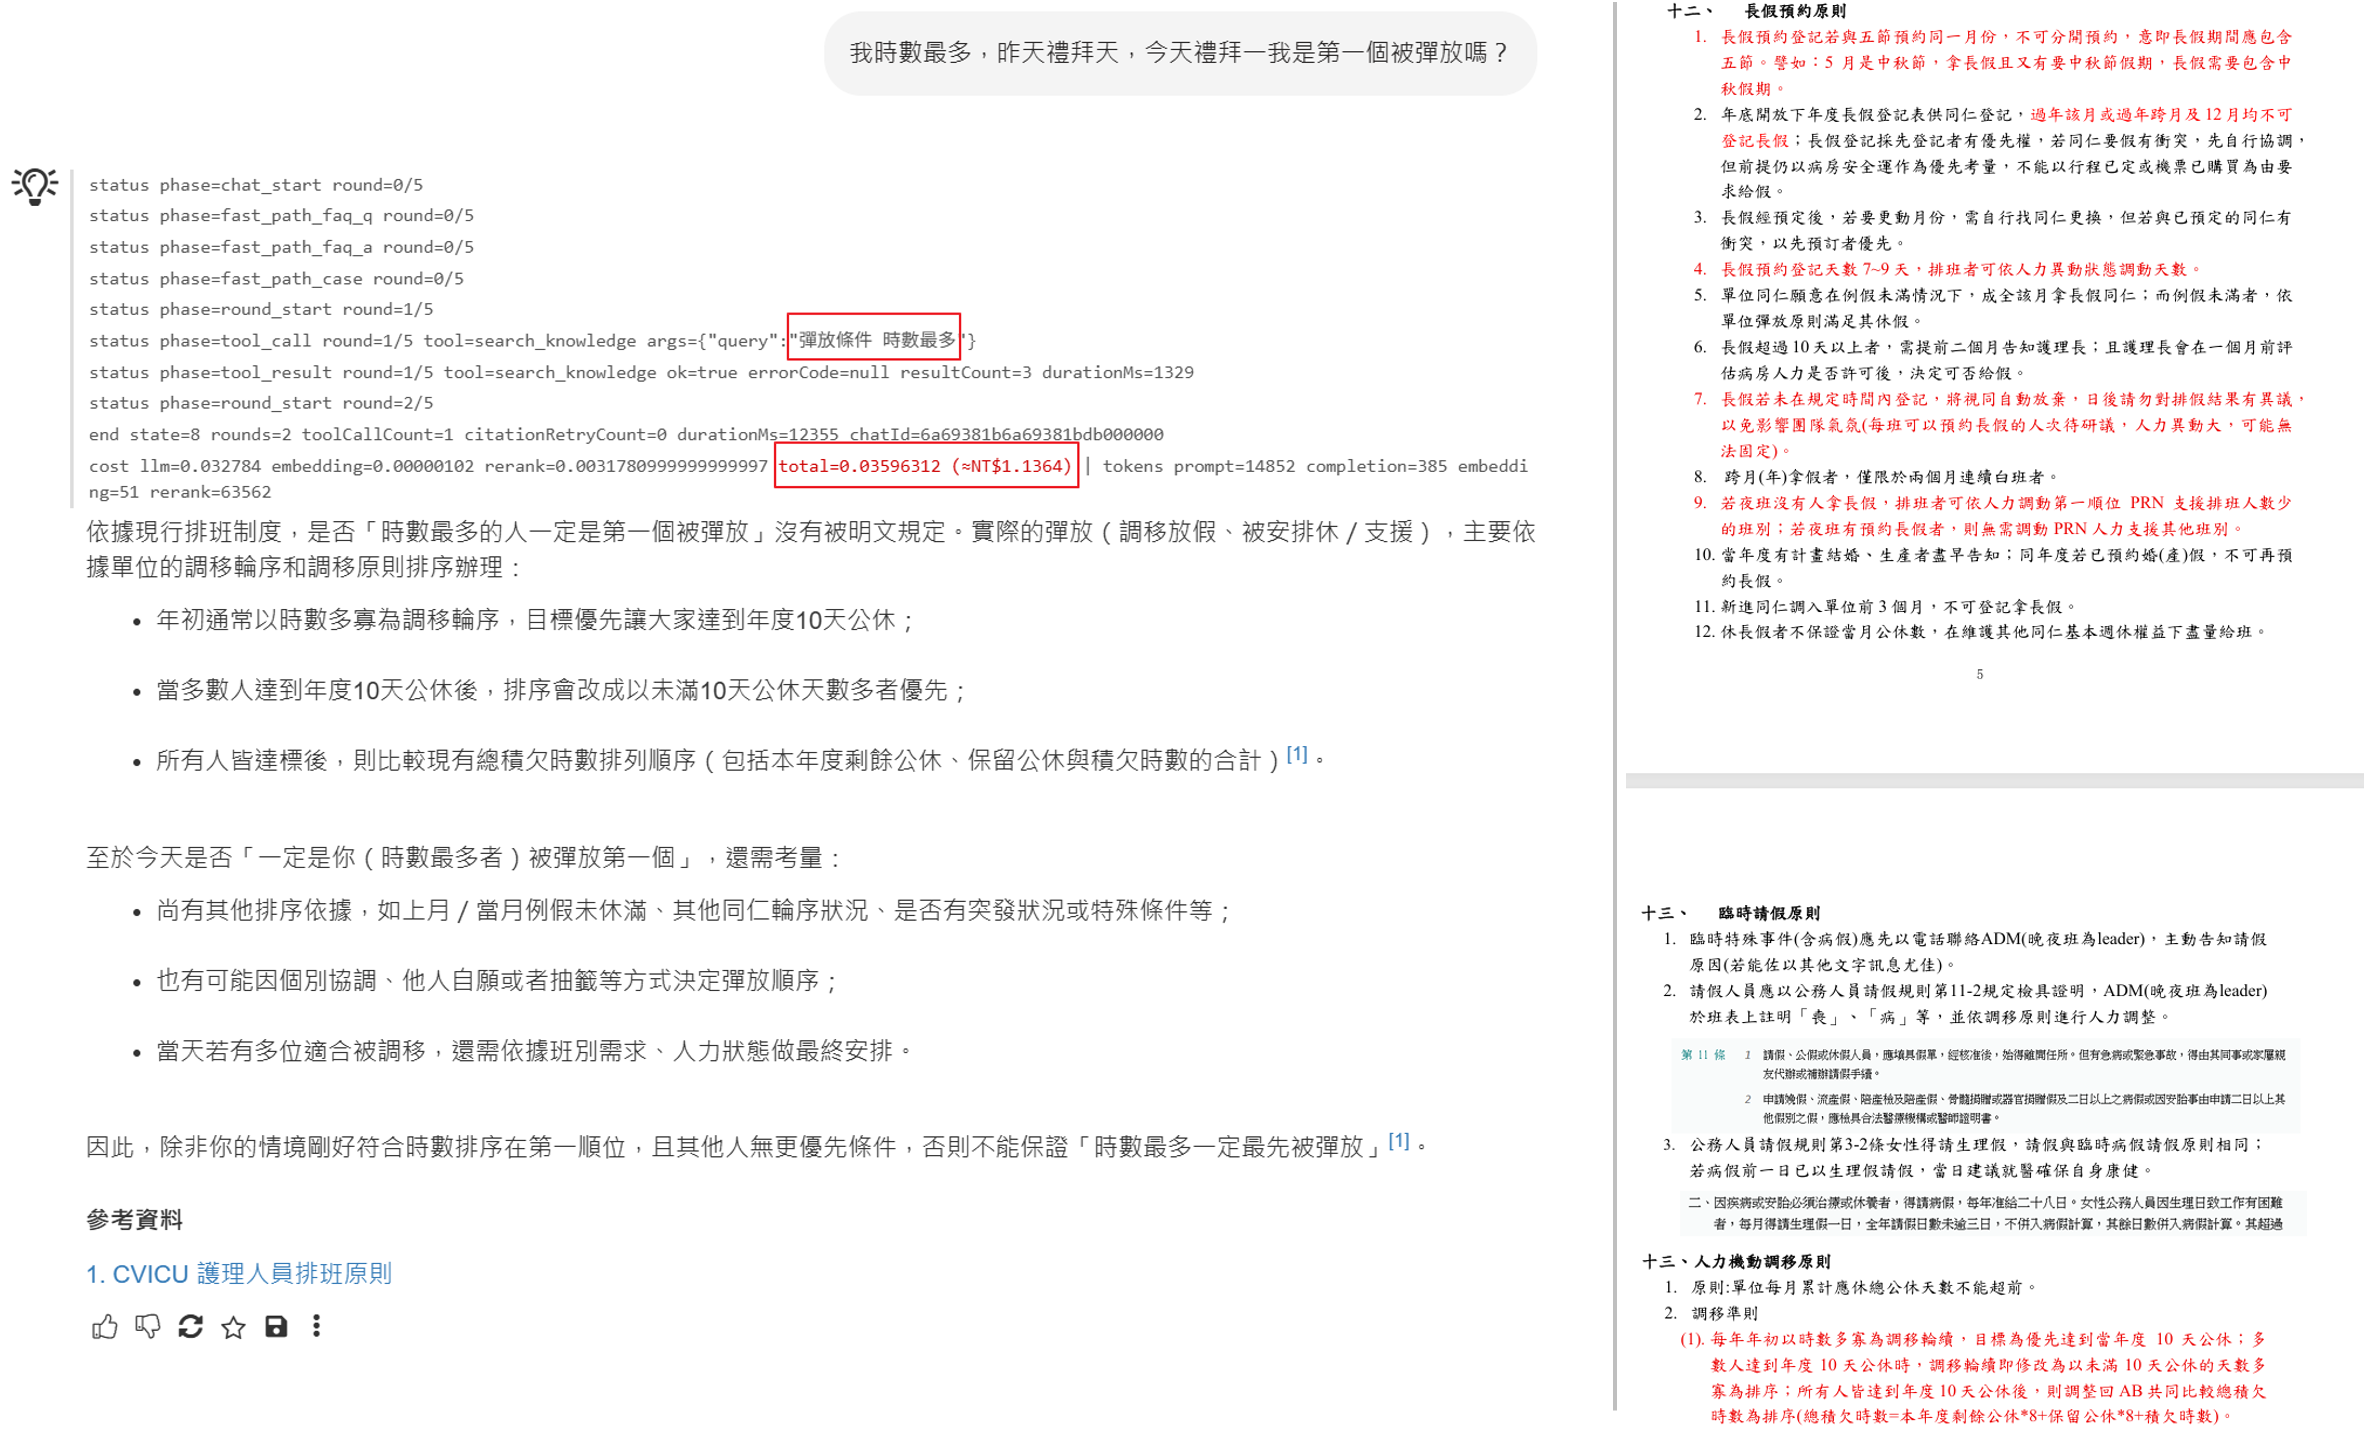
使用者問:「我時數最多,昨天禮拜天,今天禮拜一我是第一個被彈放嗎?」
這完全就是我們平常講話的口吻對吧?
充滿了時間點,口語化的條件,
還有那種只有自己人才聽得懂的內部行話「彈放」,這絕對不是你能在任何一本正式的官方員工手冊裡找到的標準句子,一般的 RAG 僅透過一次 embedding vector「相似度」的比對也通常找不到。
xms+ AI 就像有經驗的人類一樣
- 試著理解使用者想問什麼,例如「彈放條件、時數最多」
- 依據知識庫內文件提供的資料,分析並找出哪些文件與問題相關
- 再從文件內列出的一堆「原則」中解析後回答
這個過程,
尤其第三項,甚至比實際的資深專家還厲害呢!
因為文件裡面有太多規則,
多到常常都要開會討論、尋找、比對哪一條規則適用,而且有時候還無法下定論呢。
圖: xms+ AI 可以理解使用者想問什麼,並從文件的一堆規則中整理回答
問題:要有文件、成本高
AI 很厲害沒錯,但這是有前提的
- 文件要夠完整
這個例子中,幾乎把遇到的 case 都條列出來,難度很高也不好維護。 - 費用高
即使 xms+ AI 已經大幅降低 token 消耗,但這個 case 仍需要約台幣 1.1 元,小量使用還可以,當用量大時絕對是一筆需要精打細算的營運開銷。
避免 AI 幻覺
還有,讓 AI 生成還有一個大問題 ~
無法避免的 AI 幻覺 (一本正經胡說八道)。
這代表即使 95% 的情況都回答的很好,
但如果那 5% 的錯誤是不可承擔的高風險,例如,產線操作員聽信了 AI 瞎掰的答案去操作生產流程,結果搞到整批產品報廢,這種不確定性的風險,正是很多 AI 專案最後根本無法落地的原因。
AI 幻覺的解法也很直接 ~
就是「不讓 AI 生成」!
為此,xms+ AI 提供「限制 AI 生成」的功能 ,不讓 AI 生成內容,只列出參考資料就好。
當作知識管理的加強版,
透過「語意」來找資料,克服傳統用「關鍵詞」找不到的困擾,就像在內部知識庫裝一個比 Google 搜尋還強的 AI 搜尋一樣。
100 分的解法
雖然我們可以找到漂亮的解法來讓 AI 回答那 5% 的經驗,
但另外 95% 還留在資深員工的「隱性經驗」要如何克服呢?還有昂貴的 token 費用呢?
解法比我們想像中的還容易喔
只要做到每天花 10 分鐘,執行「問AI、整理FAQ」這兩個小小的行為,就能做到
- 記錄隱性經驗
- 避免 AI 幻覺
- token 費用降低到趨近於 0
更詳細的說明,